探新AI-知识库越用越乱?HyperGraph说:让文档自己“拉帮结派”

企业做 AI 知识库,常常遇到一种尴尬:上万份合同、规范、报告整整齐齐码在系统里,看着挺全,真到用的时候 —— 想找跟某个项目相关的所有资料,搜出来一堆碎片,东一榔头西一棒子,拼都拼不起来。

有没有一种可能:知识库自己管理自己?

现在的知识库,为什么越用越鸡肋?

市面上的主流工具,路子就两条,各有各的坑。

一条是向量检索。把每份文档切成小段,做语义匹配。优点是省事,缺点是文件之间完全不连通。同一个客户出现在合同 A 和报告 B 里,系统根本不认识,跨文件查资料全靠人工手动翻找。

另一条是固定图谱。实体、关系都靠人一笔一笔标进去,精度高,但维护成本更高。业务迭代快的团队,每周都要花大量人力去补节点、建新边,一不留神就滞后。知识断层一旦出现,AI 给出来的东西就少胳膊少腿。

说白了,两类工具都缺一个能力 —— 自己长大、自己更新的能力。 知识库建完的那天,就是它开始变旧的那天。

玩转AI——Gemini Notebook是我工作里最常用的AI之一,尤其是做PPT的时候

你以为它只是笔记本,其实能读资料、跑数据——Gemini Notebook来了

Google出品,把PDF、网页、表格和视频丢进去,不仅能读,还能总结、对比、画图、出成品

7月16日,Google正式把NotebookLM更名为Gemini Notebook。

名字像是换了块门牌,真正的升级却在后厨:部分付费用户已经能让它在安全云端环境中运行代码,资料分析从“帮你看懂”进化到“帮你算完”。

之前我们聊过桌面智能体、聊过文件生成工具,各有各的擅长。但Gemini Notebook切入的是另一个场景——你不是要它凭空编东西,而是要它先把你喂的材料吃透,再替你干活。

一句话概括新能力:把PDF、网页、表格和视频丢进去,Gemini Notebook不只帮你读,还能围绕原始资料做总结、对比、画图表、导出成品文件。

一、怎么用

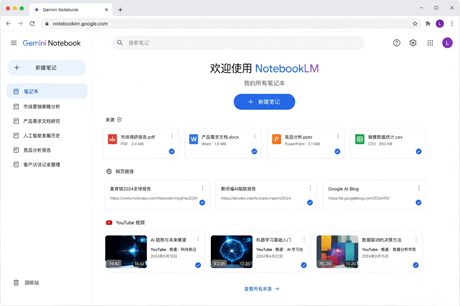
第一步,建一本笔记。登录Gemini Notebook,新建项目,把PDF、Word、PPT、CSV、网页链接、YouTube视频或录音一次性丢进去。每个项目独立管理,资料不会在不同笔记之间乱串。

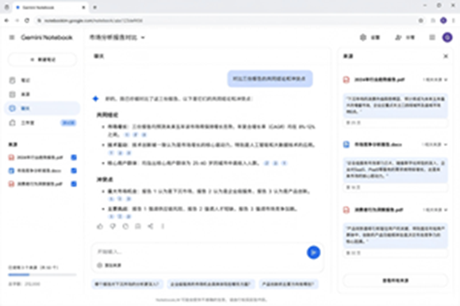
第二步,直接说人话。 别只问“总结一下”,试试这样下任务:“对比三份报告的共同结论和冲突点,每条都标出来源”“把这张CSV按月份分析,找出异常波动并解释原因”。回答会附资料引用,方便你回到原文核对。

第三步,到Studio里收成品。 你可以生成简报、思维导图、测验、音频解读、数据表或演示文稿。已开放云端计算能力的账号,还能让它运行代码、画图表、导出Excel、PPT、Word等文件。

 二、场景示例

备课做课件:上传教材、政策文件和几篇论文,让它先列知识框架,再生成课堂提问、随堂测验和讲解提纲。以前资料在文件夹里“各过各的”,现在终于肯坐下来开会了。

项目复盘:放入周报、会议纪要和数据表,要求它找出目标偏差、关键原因和下周行动。数据多时,再让它画趋势图,省掉手动筛表和拼结论。

快速吃透新领域:把行业报告、公开课视频和访谈录音放进一本笔记,先听音频概览,再沿着引用追问。适合调研、考试复习,也适合临时接到一个完全陌生的项目。

三、注意事项

改名不等于所有新功能同时到账。云端运行代码目前优先面向Google AI Ultra和部分Workspace商业用户,未来几周逐步覆盖Pro网页用户。普通用户仍可使用资料上传、基于来源问答和Studio内容生成功能。

AI回答有引用也不代表绝对正确,正式材料仍要回原文复核。上传内部资料前,确认好账号权限和分享范围。

最后聊两句

市面上AI工具分两类:一类帮你“凭空造”,一类帮你“从材料里挖”。Gemini Notebook稳稳站在后者。

它不是让你跟AI闲聊,而是让你把资料扔进去、下命令、然后拿走成果。之前我们聊的桌面智能体是帮你操控电脑完成多步骤操作;腾讯元宝是一句话生成PPT和表格;百度秒哒是零代码搭应用。Gemini Notebook做的事不一样——它解决的是“围绕一堆资料深挖、追问、出成果”这件事。

改名只是开始。Gemini Notebook最值得关注的,是“资料库”开始长出真正的执行能力——从“读懂”到“算完”,Google把它塞进了一本笔记本里。**你最想把哪一堆资料塞进Gemini Notebook?评论区聊聊,我帮你把第一条指令写好。

玩转AI-本周重磅开源!美团LongCat-2.0来了,万亿参数+国产算力自主训练

美团出品,1.6万亿参数MoE架构,MIT协议免费商用,纯国产算力训练

往期我们聊的Coze 3.0、百度秒哒,都是面向普通用户的上层应用工具。本周换个视角——AI行业迎来一个底层技术里程碑事件。

7月6日,美团LongCat-2.0正式开源,国内首款全程依托国产算力集群完成训练、推理的万亿参数混合专家大模型。对企业私有化部署、开发者二次开发具备极高价值。

一、LongCat-2.0是什么?

总参数1.6万亿,MoE混合专家架构,单Token动态激活480亿参数,原生支持百万字超长上下文读取。

6月底完成技术发布,本周正式开放完整权重、推理代码、微调工具。采用MIT开源协议,不限企业商用。华为昇腾、摩尔线程、沐曦等国产芯片同步完成适配,普通高配服务器也能本地离线部署。

最大亮点:依托五万卡国产算力集群完成全流程训练,彻底摆脱对海外高端算力的依赖,补齐国产大模型自主化的核心短板。

二、三大核心优势

全链路国产算力,数据不出境

从训练芯片到推理引擎全部国产化,数据全程本地运行不上传云端。企业内部源码、项目档案、涉密资料可以放心处理,政企和研发团队的落地门槛大幅降低。

长文本+工程代码能力突出

一次性完整解析整套项目文档、数十份行业报告,代码漏洞排查、批量工程重构、脚本生成准确率大幅优化。针对多步骤智能体任务做了专项调优,长链路工作逻辑连贯性更强。

完全免费开源,部署成本低

模型和推理框架无商用限制,不用持续付云端API费用。配套轻量化压缩方案,中小团队不需要高额算力投入,就能搭建专属私有大模型底座。

三、能用在哪些场景?

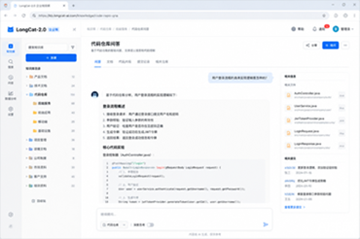
企业研发内部知识库:批量解析项目源码、历史方案、行业档案,搭私有问答系统,自动迭代文件、排查代码问题,内部数据本地留存。

海量资料批量复盘分析:一次性读取长篇台账、行业调研资料,自动提取核心数据、生成对比报告,适合大批量档案归档和周期性业务复盘。

开发者低成本二次开发:基于开源底座定制行业专用AI、本地文档处理智能体,不用从零训练大模型,大幅缩短自研周期。

四、怎么上手?

去美团开源仓库、ModelScope或HuggingFace下载完整模型包和推理脚本。在国产算力服务器或高配主机上部署,官方提供了轻量化启动工具。本地离线上传文档和代码直接下发指令,支持百万字批量解析。开发者可以基于源码微调,打造适配自身行业的定制化模型。

五、核心亮点小结

本周最新开源的重磅技术产品,填补了国产万亿大模型自主训练的空白。开源商用无限制,本地私有化部署方案成熟,隐私和合规优势明显。长文本、代码、多步骤任务表现领先。多品牌国产芯片同步适配,硬件选择灵活。

定位精准面向企业级私有化部署,原生交互以开发者工具为主,技术团队可直接调用API或命令行高效集成;普通个人用户可关注社区后续推出的轻量封装版本。

写在最后

最近AI产品大多扎堆做个人办公和轻量化应用,底层自主可控的开源大模型新品确实稀缺。本周开源的美团LongCat-2.0,兼顾国产算力自主、免费商用、离线本地运行三大核心优势。

对于有大批量资料梳理、项目研发、私有数据处理需求的企业和开发者,这款模型有长期实用价值——不用持续订阅云端服务,本地运行也能保障内部资料安全。

你是企业技术负责人还是独立开发者?评论区聊聊,帮你看看LongCat适不适合你的场景。

玩转AI——7月重磅!腾讯混元Hy3上线,元宝免费帮你做PPT、Excel、PDF

腾讯出品,295B参数新模型,文件生成功能个人永久免费

往期我们聊过团队协同的Coze 3.0、零代码搭应用的百度秒哒,都是各自赛道的实用选手。本周迎来7月首个重磅大模型更新——腾讯混元Hy3正式发布,同步打通元宝全端产品,免费开放Agent任务能力。

一句话概括这次更新的核心价值:不用切换多款工具,一句话自动生成PPT、Excel、PDF等完整办公文件,全程免费。

一、混元Hy3是什么?

7月6日,腾讯正式发布新一代混合专家大模型混元Hy3,295B总参数、21B动态激活参数,靠快慢双思考架构大幅降低模型幻觉、提升多步骤任务稳定性。

对比前代,常识错误率减半,文本幻觉率下降超50%,工具调用和长链路任务规划能力跨越式升级。

发布当天,腾讯元宝全端同步接入Hy3底座,上线全新免费Agent功能——不用额外开通权限,切换模型就能直接用。

二、两大核心亮点

文件一站式交付,全流程自动闭环

普通AI只输出文字,Hy3驱动下的元宝Agent能自主拆解需求,自动完成素材搜集、数据整理、排版制作,直接交付可下载的成品文件。

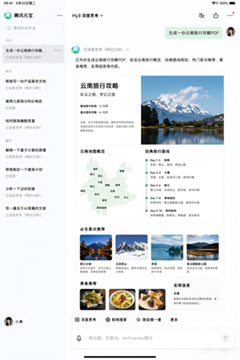
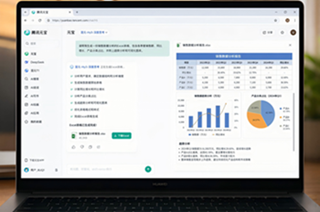
日常办公一句指令搞定整套活:制作市场分析PPT、输出数据统计Excel、生成旅行攻略PDF、搭建互动教学HTML页面。不用手动复制粘贴、不用二次排版,多轮对话还能反复调整版式和内容。

免费+轻量,上手零门槛

不用下载独立客户端、不用搭建工作流、不用调提示词。打开腾讯元宝,切换「Hy3深度思考」模式就能触发任务智能体,全部文件生成功能个人永久免费。

API同步降价,输入Token低至1元/百万,中小企业批量接入成本也很低。

三、能帮你干哪些活?

职场办公:自动生成工作汇报PPT、数据复盘表格、项目方案Word文档,省去排版制图汇总的大量时间。

内容创作与规划:撰写完整调研报告、一键生成多日出行攻略PDF,自动整合路线预算景点信息。教学素材:快速搭课堂互动小游戏、知识点自测工具、习题汇总文档,几分钟成型。

四、怎么用?

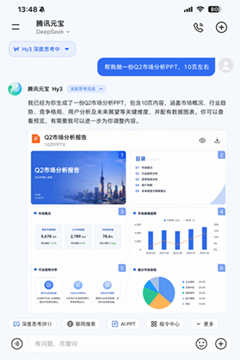
打开腾讯元宝APP或网页端,更新到最新版本。模型选择栏切到「Hy3深度思考」模式,直接完整描述需求、注明要什么格式——比如“帮我做一份Q2市场分析PPT,10页左右”——AI自动执行全流程任务。生成完一键下载,不满意就继续对话调整。

五、亮点小结

本周最新上线的模型能力,轻量化办公智能体免费开放,无额外付费门槛。幻觉控制和多步骤任务稳定性大幅优化,成品文件完整度高。依托元宝原生客户端,无需额外软件,手机电脑随时随地可用。API低价开放,企业和个人开发者都能低成本接入。

写在最后

近期AI赛道不少产品扎堆卷电脑自动操控,上手门槛偏高,普通用户用不太上。而腾讯混元Hy3+元宝Agent的组合,精准瞄准大众高频办公需求——把完整文件生成能力免费下放,不用复杂配置,不用额外软件,一句话产出可直接用的成品资料。

经常写汇报、做表格、整理方案的,可以直接打开元宝免费体验,省下大把重复性文书时间。

你最想让元宝帮你生成什么文件?评论区聊聊,我帮你试试能不能做。

探新AI-AI幻觉,正在成为我们新的信息困境

深夜向 AI 咨询出行路线,它条理清晰给出换乘方案,附带精准首末班时间。等到第二天到站,才发现这条线路早已停运三个月。
写作业查史料,AI 颠倒朝代更迭,还凭空捏造论文出处;职场写报告,AI 填充的行业数据、客户案例全部无中生有。

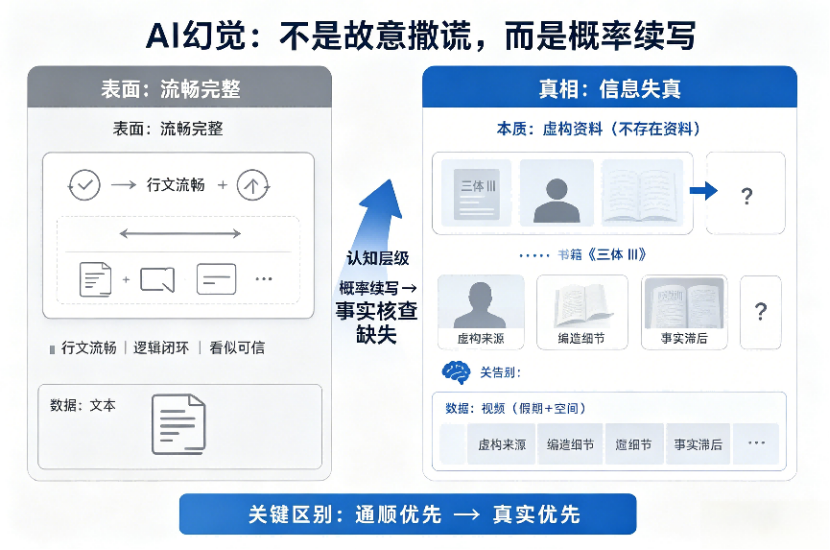
AI 不是刻意撒谎,这个普遍现象,行业有个专业名词:AI 幻觉。

相关调研显示,42.2% 的用户反馈使用 AI 时最头疼的问题就是信息失真。

它最迷惑人的一点是 “一本正经造假”:行文流畅、逻辑闭环,甚至虚构期刊、学者、行业报告,普通人很难一眼分辨。

ChatGPT、DeepSeek 这类大语言模型,本质是概率文字接龙工具。它学习海量文本,只计算 “哪个词紧随其后概率最高”,核心目标是生成通顺句子,而非保证内容真实。

当模型遇到训练库里不存在、记忆模糊的知识点,为了保证语句连贯,就会自主编造信息填补空白。
举个例子:现实不存在《三体 Ⅳ》,如果你询问它的作者,AI 依旧会编造人名、故事梗概。对它而言,完整输出优先,事实对错不在第一优先级。

简言之:幻觉不是程序 bug,是大模型天生的底层机制缺陷,但我们有多种实用方法降低幻觉概率。

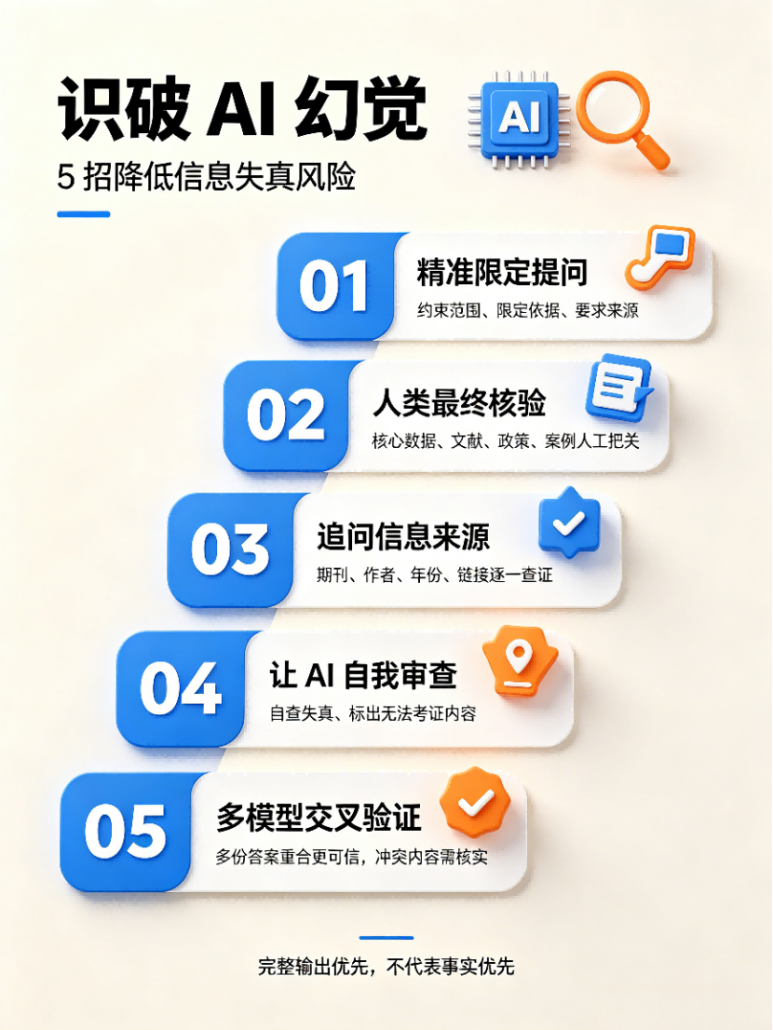
今天我们简单聊聊怎么应对 AI 幻觉

第一招:精准限定提问,缩小 AI 发挥空间

宽泛提问极易催生编造。
反面示例:介绍李白
正面规范提问:依据《新唐书・李白传》原文,梳理李白出生年份、仕途经历与代表作,每条内容标注史料来源。

选购手机同理:
宽泛版:推荐拍照手机
严谨版:2025 年发布、预算 3000-4000 元安卓机型,侧重夜景拍摄,罗列三款并客观对比硬件优缺点。约束范围、限定依据、要求标注来源,大幅压缩 AI 编造空间。

第二招: AI 只是初稿工具,人类最终核验

把 AI 看作实习生,而非行业专家。
适合交给 AI:搭建框架、撰写初稿、发散思路、整理素材;
必须人工把关:全部核心数据、引用文献、政策原文、商业案例。

第三招:追问信息来源,快速识别编造

凡是 AI 输出数据、研究、文献、政策,立刻追问出处:这份研究发布期刊、作者、发表年份?
自带联网检索、引用标注的模型优先使用,有原文链接可一键核验。
如果 AI 含糊回避、不断编造新线索,直接判定该段落存疑,需要自行查证。

第四招:让 AI 自我审查,提前排查漏洞

拿到回答后追加提示:站在事实核查角度,自查本段所有内容,标出存在失真、无法考证的内容。
AI 切换质检视角后,能主动暴露一部分逻辑与事实漏洞,虽不能完全杜绝错误,但可以快速定位高风险段落。

第五招:多模型交叉验证,多方比对

同一个问题分别使用豆包、DeepSeek、GPT 等不同模型作答。
多份答案高度重合,内容可信度更高;各执一词、信息冲突,代表模型都在依靠概率猜测,须核实资料。
很多科研人员整理文献时,会用双模型输出摘要,对比差异,快速找出 AI 编造内容。

短期之内,AI幻觉还不会消失。但这不意味着只能被动踩坑。普通用户完全可以通过一套简单的习惯,把被“忽悠”的风险降到最低。

不妨把AI当作一个脑子快、但偶尔会信口开河的灵感搭档,只需要记住两个动作:关键信息随手溯源,重要结论交叉核对。凡是涉及具体数据、人名、政策、时间的内容,多问一句“这个说法从哪来的”,再跟权威信源或另一个AI的答案对一下,很多幻觉自然就现了原形。

说到底,工具越强大,使用它的人就越需要清醒。

玩转AI——微信和支付宝同时“长”出AI了,这次不用下载新APP

微信小微、支付宝阿宝双双开启内测,零下载零注册,即用即走

前几期我们聊的都是桌面端智能体、独立AI应用,多少都要走一遍“下载→安装→注册→登录”的流程。本期换个视角——你每天已经打开的APP里,自己长出AI了。

6月中下旬,微信「小微」和支付宝「阿宝」先后启动内测。两款产品逻辑一致:不新增APP,不重新注册,原生嵌入,随手唤起。下面直接讲清楚它们是什么、能干什么、怎么用。

一、先认识一下这两位“原住民”

微信·小微(6月20日小范围灰度内测)

基于微信自研WeLM大模型,无需下载新程序,更新微信最新版本后,有内测资格的用户点击首页左上角图标或右滑即可唤起。深度打通聊天、文件、收藏、公众号、小程序整套微信生态——能看群聊、能读文件、能调小程序,主打社交办公一体化。

支付宝·阿宝(6月16日邀请制内测)

支付宝史上最大交互改版,右滑切换AI专属界面,重构了原本繁杂的菜单栏逻辑。依托支付、理财、生活服务底层体系,聚焦收支管理、便民办事、生活规划——查账单、缴水电、找充电桩,一句话直达。

二、它们比独立AI工具强在哪?

零下载零注册,即用即走

不用反复安装、登录多款AI软件,随手唤起处理临时事务,操作链路大幅缩短。

深度打通原生生态,数据流转更顺畅

小微可以直接读群聊内容、总结长文档、梳理收藏文章、一键调起小程序;阿宝能自动解析个人账单、归集资产明细、直达政务生活服务。不用手动上传文件,效率碾压外部通用AI。

隐私权限可控,敏感信息不上传

聊天记录、收支流水均设独立授权开关,你可以自主决定AI读取范围。转账、付款等资金操作必须本人二次确认,杜绝风险。

不用学提示词,说人话就行

不要求用户学什么提示词工程、搭建工作流,口语化下指令就能完成操作。普通用户上手几乎没有门槛。

三、能帮你干哪些活?

办公协同:自动整理群聊会议纪要、提炼通知重点、改写正式文案

资料处理:总结公众号长文、解读转发来的PDF、检索历史聊天文件

社交辅助:写朋友圈文案、定制节日问候、优化沟通话术

便捷办事:一句话打车、点餐、挂号,自动跳转小程序完成预约

支付宝·阿宝的擅长场景

收支统筹:月度开销分类统计、生成消费分析报告、梳理还款定投计划

便民业务:一键查社保公积金、缴水电费、预约寄件、找充电桩

理财科普:通俗解读理财产品、梳理资产配置思路、解答基础理财疑问

账单管理:快速筛选历史收支、对账整理、开具电子凭证

四、怎么用上它们?

微信小微:升级微信到最新版本,有内测资格的直接滑动或点击图标唤醒,按需开启数据读取权限即可对话使用。暂时没入口的,等后续分批推送。

支付宝阿宝:更新支付宝新版,输入官方邀请码获取内测资格,右滑切换AI界面,按需开放账单和定位权限后下发指令。资金操作全程需本人确认。

两款助手都可以随时关闭授权、清空对话记录,隐私边界你自己说了算。

五、核心亮点

赛道新颖,避开桌面智能体的同质化内卷,内嵌原生AI是目前行业最新方向。依托十亿级用户APP,普及潜力大,轻量化高频体验流畅。深度匹配社交、支付独有场景,实用性强于通用AI。大厂原生安全体系完善,敏感数据权限可控。

前一阵AI产品扎堆卷客户端自动化、电脑操控能力,同质化越来越明显。而微信小微和支付宝阿宝的内测,标志着一个新拐点:AI不再是需要主动下载的独立工具,而是嵌入日常高频软件、随取随用的基础能力。

对于绝大多数普通用户来说,不必堆砌各种

AI软件。每天必开的微信和支付宝里,已经能搞定文案整理、资料归纳、收支规划、便民办事这些高频琐事。随着内测范围持续放开,内嵌式AI很可能成为最普及的AI使用形态。

你拿到小微或阿宝的内测资格了吗?评论区聊聊体验。
玩转AI-不写代码,不配环境,3分钟造一个专属AI应用——百度秒哒全量上线了

百度出品,基于文心大模型,一句话生成AI应用,个人免费试用

上一期我们聊了团队协同的Coze 3.0,很好用的工具。但不少读者后台留言说:工具是好用,但我想做一个专属于自己的小AI程序,还是得懂代码、配环境,门槛太高了。

今天聊的这款——百度秒哒,刚好补上这个缺口。

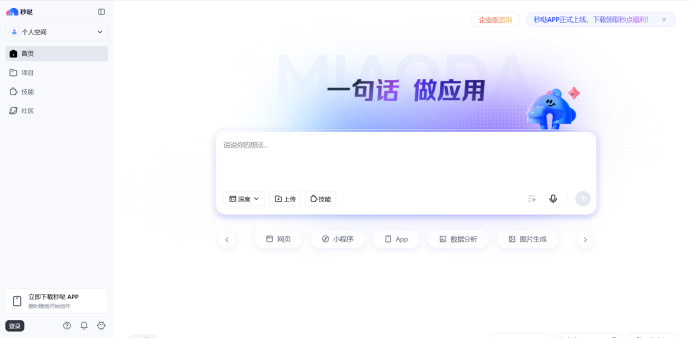
一句话介绍它:零代码搭建AI应用平台,你说需求,它帮你把应用做出来。

不管是自用的小工具、内部知识库问答机器人,还是轻量自动化流程,输入需求描述,平台自动完成逻辑搭建、功能调试、页面生成。简单应用3分钟成型,复杂场景一小时搞定。

它能帮你做什么?

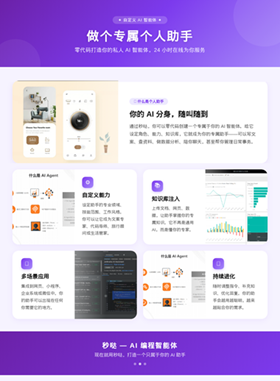
  • 做个专属个人助手

你可以搭建一个文档梳理机器人,定向读取你电脑里的资料,一问一答精准检索内容;也能做个文案润色、表格处理、摘要总结的小工具,不用反复切换不同AI网页,打开自己的应用就能干活。

  • 搭个内部知识库

把部门制度、项目资料、培训文档批量导入,搭一个专属问答机器人。同事有问题直接问,不用翻文件夹、不用重复答疑。资料权限自己掌控,方便又安全。

  • 整个自动化小流程

数据统计、信息汇总、表单整理、内容排版……这些重复活儿都能做成自动化小程序。设置好固定逻辑后,一键触发批量处理,省下大把时间。

怎么上手?四步走

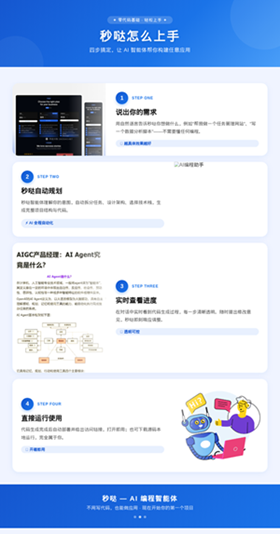
打开秒哒官网,百度账号一键登录,免费额度自动开通。

在创建页面直接用大白话描述你想要的功能——比如“我想做一个能回答公司请假制度的问答机器人”,平台自动拆解逻辑、生成应用框架。

按需上传参考资料、调整问答规则、设置访问权限,简单预览测试后就能发布。

生成后的应用支持网页分享、内部链接分发,也能嵌入常用办公页面。

  • 几点真实体验

优点很明显:零代码门槛极低,没有编程基础的人也能上手。文心大模型加持,中文语义理解和长文档处理能力靠谱,知识库问答准确率稳定。权限体系完善,可以灵活设置公开或内部访问。后期修改功能、补充资料,直接编辑描述就能更新,不用重新搭。

不足之处也有:复杂多步骤联动的应用,自动生成的逻辑偶尔有疏漏,需要手动微调。免费版有调用次数上限,高频大规模商用得升级套餐。第三方系统深度对接能力有限,更适合轻量自用和内部小场景。

  • 传统代码开发与秒哒区别

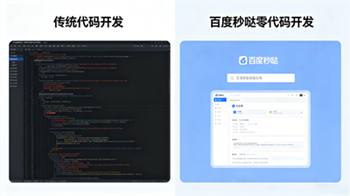
传统开发:你需要懂编程语言、写函数逻辑、调API接口、处理报错、部署上线——一句话概括,得会写代码。

秒哒:你只需要说“我想做一个内部资料问答机器人”,它自动把应用逻辑搭好、页面生成好、功能跑通——一句话概括,只需要会说人话。

简单类比:以前是自己动手炒菜,从切菜到颠勺样样精通才能吃上饭;现在是你说“我想吃辣的”,厨房自动给你端出来一盆水煮鱼。前提是你得描述得清楚,剩下的事儿它办。不过如果是开连锁餐厅级别的需求,该请厨师还是得请。

AI工具早就不是大厂和技术人员的专属了。从使用现成工具,到按需打造自己的AI应用,正在变成新趋势。

百度秒哒把开发门槛降到几乎为零,你不用懂代码,就能根据自身工作痛点定制专属助手。小需求用免费版就够用,真正借助AI把重复活简化,把精力留给正事。

你最想做一个什么样的AI应用?评论区说说需求,我帮你想想能不能用秒哒实现。

探新AI-跟AI聊了一小时,它真的会共情么?不!它脑子里全是“Token、Token、Token”

深夜 emo 了,打开大模型,噼里啪啦打了五百字,把从小到大的委屈全倒给它。它回复你:“我理解你的感受,这确实很不容易。”

你心里一暖 —— 哇,它懂我。

别感动了。

我帮你翻译一下它脑子里真正在想什么:“第 1 个 Token、第 2 个 Token、…… 第500 个 —— 好的,现在该预测第 501 个 Token 了。”是不是瞬间下头?
今天我们就来扒一扒,这个让 AI “假装共情” 的幕后黑手 ——Token。

Token 到底是啥?往小了说,就是 AI 的 “一口量”

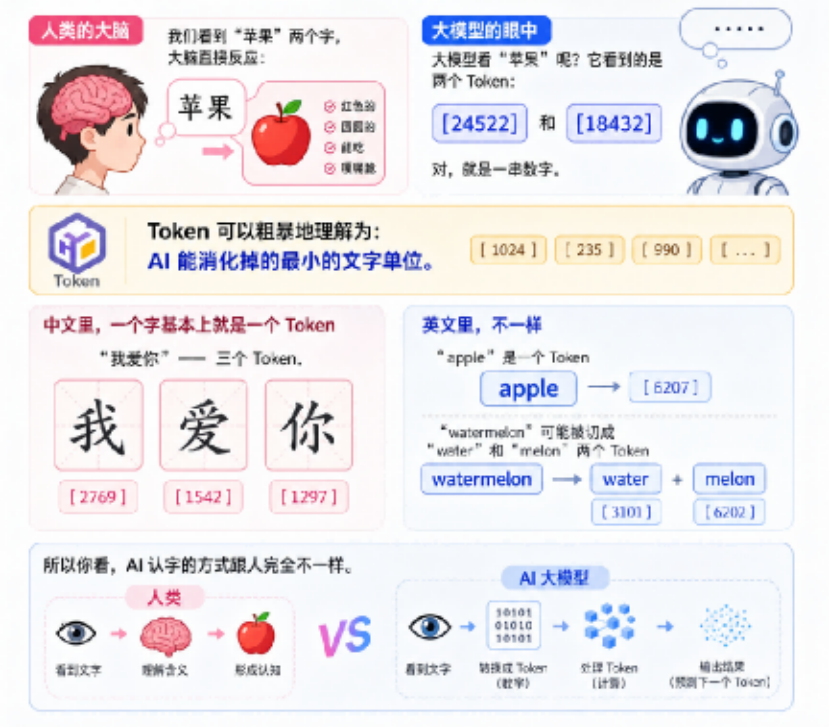
我们看到 “苹果” 两个字,大脑直接反应:红色的、圆圆的、能吃、嘎嘣脆。

大模型看 “苹果” 呢?它看到的是两个 Token:[24522] 和 [18432]—— 对,就是一串数字。

Token 可以粗暴地理解为:AI 能消化掉的最小的文字单位。有人把它翻译成 “词元” 或者 “标记”,中文里,一个字基本上就是一个 Token。“我爱你”—— 三个 Token。英文里不一样。“apple” 是一个 Token,“watermelon” 可能被切成 “water” 和 “melon”两个 Token。

所以你看,AI 认字的方式跟人完全不一样。

Token 怎么 “切”?AI 有个秘密小本本

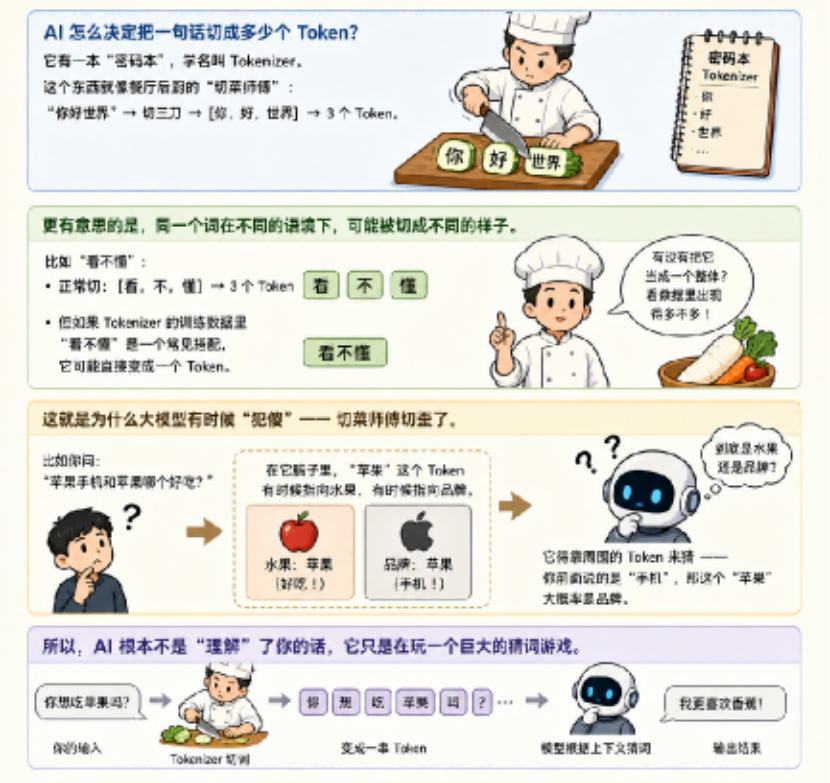
AI 怎么决定把一句话切成多少个 Token?
它有一本 “密码本”,学名叫 Tokenizer。这个东西就像餐厅后厨的 “切菜师傅”:“你好世界” → 切三刀 → [你,好,世界] → 3 个 Token。

更有意思的是,同一个词在不同的语境下,可能被切成不同的样子。
比如 “看不懂”:正常切:[看,不,懂] → 3 个 Token,但如果 Tokenizer 的训练数据里 “看不懂” 是一个常见搭配,它可能直接变成一个 Token。

这就是为什么大模型有时候 “犯傻”—— 切菜师傅切歪了。
比如你问:“苹果手机和苹果哪个好吃?”AI 可能会懵。因为在它脑子里,“苹果” 这个 Token 有时候指向水果,有时候指向品牌。它得靠周围的 Token 来猜 —— 你前面说的是 “手机”,那这个 “苹果” 大概率是品牌。

所以,AI 根本不是 “理解” 了你的话,它只是在玩一个巨大的猜词游戏。

Token 是大模型的 “生命线” 和 “紧箍咒”

你用 大模型 的时候,是按 Token 收费的。
输入 Token:便宜一点
输出 Token:贵一点

你的一篇两千字的文章,大概 2500 个 Token,差不多人民币一毛多。听起来不贵是吧?但大模型每天要处理几十亿次请求,这个账单是天文数字。所以免费的大模型有字数限制、速度限制 —— 不是它不想快,是Token太贵了。
你的每一次 “你好”,在它眼里都是:1 个 Token 到账。

为什么说 “大模型不懂你”?

回到开头的那个问题。
AI 真的能共情吗?
不能。

它只是在你的五百字里,看到了五百个 Token。然后根据这些 Token 的排列组合,预测出最有可能的下一个 Token——“我理解你的感受”。

这不是共情,这是概率。大模型的 “阅读理解”,本质上就是 Token 的排列组合。它不知道 “难过” 是什么意思,但它的训练数据里有 几亿次 “当用户说难过,后面通常会接安慰的话”。于是它就那么回了。

知道了 Token 的秘密,你再跟 AI 聊天的时候,可以做两件事:

  • 把话说 “碎” 一点

因为 Tokenizer 切词的逻辑有时候很蠢。如果你发现 AI 答非所问,试试把长句子拆成短句子。就像跟外国人说话,语速慢一点、单词简单一点。

  • 别对 AI 投入感情

它真的不是懂你。
它只是 —— 在 Token 的海洋里,为你预测了下一个最温暖的词。

下次再跟 大模型 聊到深夜,看到它说出那句 “我理解你” 的时候 ——你可以在心里默默翻译一下:“第 1 个 Token、第 2 个 Token…。”


它是大模型世界的 “最小积木”,是大模型的 “金钱”。
它让 AI 变聪明,也让 AI 显得蠢。

但最重要的是,它提醒我们一件事:
AI 没有灵魂。它只是一台极其擅长排列组合的概率机器。
至于 “灵魂” 这东西 —— 还是留给人类自己吧。

玩转AI-”Hermes Desktop 使用报告:它干活,我摸鱼,双赢“

Hermes Desktop:一个让你从此“懒得亲自操作”的桌面智能体

开源免费、有记忆、能跨系统干活——关键是,真的很好用

各位被重复工作逼疯的小伙伴,今天聊一个开源桌面智能体——Hermes Desktop。

试用几天后,我决定把它装进主力电脑。这篇只讲怎么用:怎么让它干活、在哪儿薅它、有哪些注意事项。包教包会。

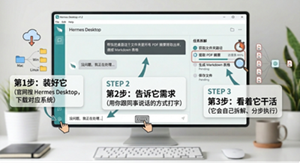
一、怎么让它干活:三步上手

第一步:装好它

官网搜 Hermes Desktop,下载对应系统(Win/Mac/Linux 都行)。装完打开,看到一个聊天框——别慌,它不是普通聊天机器人。

第二步:告诉它需求

用你跟同事说话的方式打字就行。例如:

“帮我把桌面这个文件夹里所有 PDF 摘要提取出来,做成 Markdown 表格”

“每天下午五点检查服务器 CPU,超80%就发邮件给我”

就当它是一个手速极快、但需要你交代清楚的实习生。

第三步:看着它干活

它会自己拆解任务、分步执行,做完告诉你结果。出错会尝试换方案,实在不行会停下来问你。

隐藏技能:长效记忆

它记住你让它做过的事。下次你说“再做一次”,它直接开干,不用重新教。适合每周都要跑的重复活。

收费吗? 公测基础功能全免费,高阶沙箱才收费。

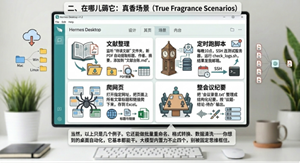
二、在哪儿薅它:真香场景(远不止这些)

· 文献整理:对它说“监听‘待读文献’文件夹,新 PDF 自动提取标题、作者、摘要,添加到‘文献台账.md’。”每下载一篇,它自动记一笔。

· 定时跑脚本:“每晚10点,SSH 连测试服务器,运行 check_logs.sh,结果发我邮箱。”它自己连、跑、发,你安心睡觉。

· 爬网页:“打开这个网址,把页面上所有文章标题和链接爬下来,存到 Excel。”不用写一行代码。

· 整会议纪要:“把‘会议录音.txt’整理成结构化纪要,按‘议题-结论-待办’输出。”它归纳好,你复制粘贴。

当然,以上只是几个例子。它还能做批量文件重命名、格式转换、数据清洗、自动发消息……你想到的桌面自动化操作,它基本都能干。大模型内置的能力可不止四个,别被固定思维框住。

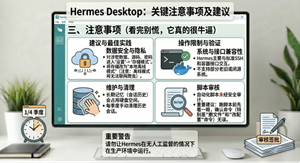
三、注意事项(看完别慌,它真的很牛逼)

说实话,再好的工具也有脾气。但千万别因为我写了几条注意事项就觉得它雷点多——恰恰相反,Hermes Desktop 是我见过最牛逼的开源桌面智能体之一,免费、有记忆、能跨系统干活,市面上很难找到第二个。只是为了让你们用得爽不翻车,该提醒的还是得提醒:

默认情况下它会把会话记忆存到云端,所以涉密数据、源码、密码建议去设置里改成本地离线模式(但离线后不能联网爬虫)。它只认标准 SSH 和容器接口,老旧闭源系统别指望它操作,更不要让它无人值守改生产环境。长期记忆会占硬盘,记得每季度手动清理一下历史会话。另外,它自动生成的脚本没有经过安全审计,建议你先看一眼、改一改再跑,尤其是删文件改配置的命令。

只要注意这几点,剩下的就交给它去卷吧。

Hermes Desktop 是开源圈少有的免费、有记忆、能跨系统干活的桌面智能体。整理文献、跑脚本、爬网页、整纪要——它能干的活比你想象的多得多。

别被几个小提醒劝退,它真的很牛逼。你只管动嘴,它替你动手。

你最想让它替你干什么?评论区告诉我。

韬定律:芯片界的“空间折叠术”,不靠变小靠变巧

华为,给全球半导体写下了新序章。

过去半个世纪,芯片行业只有一条路:把晶体管越做越小。从微米到纳米,从 28nm 到 3nm,一场 “针尖上跳舞” 的竞赛,越跑越吃力。3nm 之后是 2nm,2nm 之后逼近 1nm,物理极限近在眼前。更严峻的是,先进制程的产线成本动辄数百亿美元,连行业巨头也难以承受。

就在全球陷入瓶颈之际,华为在上海抛出了改写行业的重磅答案 ——韬(τ)定律。

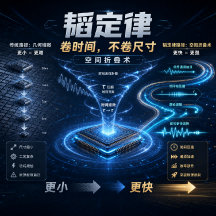
不卷尺寸,卷时间

2026 年 5 月 25 日,ISCAS 2026 国际会议现场,华为半导体业务总裁何庭波正式发布韬定律。这是中国首次提出指导全球半导体演进的原创理论。不再跟随,不再模仿,而是站在产业前沿,重新出题。

韬定律的核心,是时间缩微。

传统路径是 “几何缩微”:拼命缩小晶体管,在面积里堆密度。韬定律另辟蹊径:不把器件做小,而是让信号跑得更快。物理学中,τ 代表时间常数,衡量系统信号传输的基础耗时。韬定律的思路,就是系统性压缩时间常数,让芯片内部信号以更高效率流转。

一句话:从拼 “更小”,转向拼 “更快”。

逻辑折叠:芯片的 “空间折叠术”

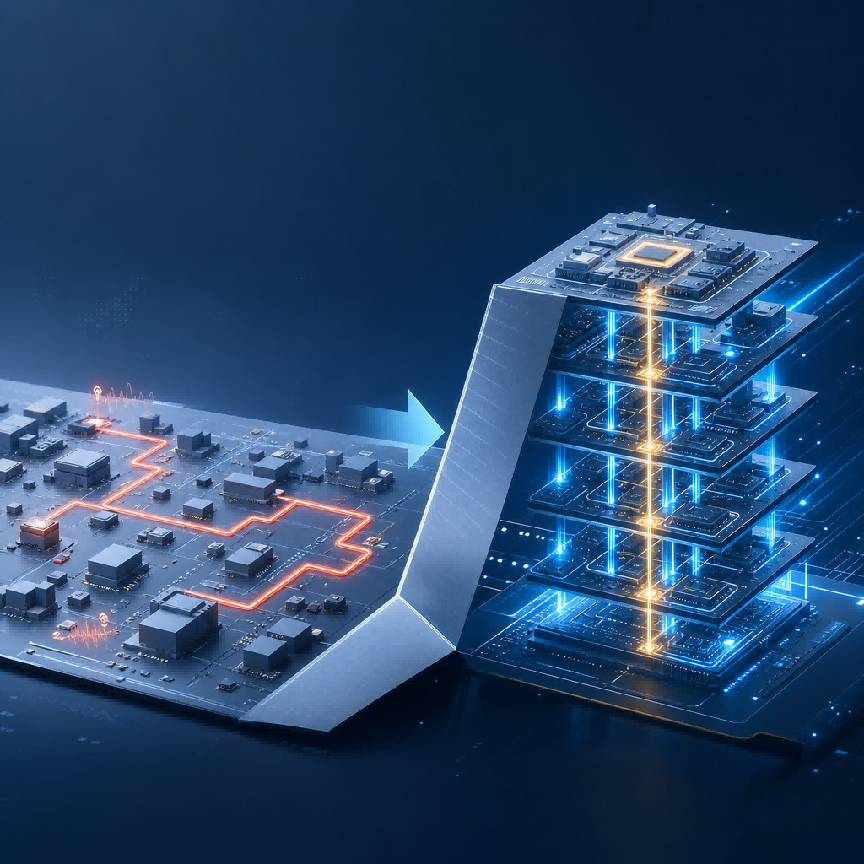
传统芯片像一座二维城市,晶体管平铺在平面上,信号跨区传输路径长、延迟高、损耗大。华为的逻辑折叠技术,直接把这座城市从平面 “折成高楼”。同一模块内部的逻辑单元,从平铺分布,变成垂直多层堆叠。原本相隔遥远的电路,变成上下紧邻,信号直达、路径骤减、延迟大幅压缩。

很多人会问:这不就是 3D 堆叠?

完全不同。


普通 3D 堆叠是 “成品模块摞起来”;华为逻辑折叠是在设计之初,把最基础的标准单元打散、重构、分层、重砌。别人是 “搭积木”,华为是 “盖新楼”。结果就是:传输距离缩短、寄生效应骤降、速度更快、功耗更低。

硬核数据:量产验证,不是实验室概念

韬定律不是纸面理论,而是已经量产的成熟路径。何庭波披露:过去六年,基于韬定律思路,华为已量产 381 款芯片,覆盖多品类、全场景。首个面向消费端的重磅落地,就是2026 秋季发布的麒麟 2026,逻辑折叠技术首次商用,数据亮眼:

晶体管密度:+53.5%(155→238 MTr/mm²)

P 核能效:+41%

峰值频率:+12.7%(3.1GHz)

SRAM 频率:+40% 以上

时钟缓冲器:减少 50% 以上

关键突破:所有提升,不依赖先进光刻工艺。换句话说,华为用架构创新,绕过物理极限,用成熟工艺跑出先进性能。

不止华为:中国给出行业新规则

摩尔定律主导半个世纪,全球产业被 “先进制程” 单一赛道绑定,技术、设备、成本三重壁垒,垄断固化。韬定律的意义,远超一家企业、一款芯片:它为后摩尔时代开辟了全新赛道。

核心逻辑很简单:
不用死磕纳米,成熟工艺也能做出高性能;
不拼极致制程,拼架构、效率、系统优化。这正是任正非所提:以数学补物理、非摩尔补摩尔、群计算补单芯片。
韬定律,就是这句话的落地答案。对全球行业而言,垄断格局被撕开缺口;对中国半导体而言,从追赶者,变成规则定义者。

未来十年:从两层折叠,走向全域多层

麒麟 2026 只是起点,采用的仍是局部关键路径折叠、混合键合间距 1.5 微米。下一步路线清晰:

2027:麒麟芯片进入Silicon状态,折叠技术全面成熟;

2031:晶体管密度目标 400+ MTr/mm²,等效 1.4nm 制程;

2035:逻辑折叠走向全规模、多层堆叠,昇腾 AI 芯片集成度提升 100 倍以上。

未来十年,芯片将从平面走向立体,从单层走向多层,性能提升不再依赖制程跃进。

关上一扇门,打开一片天

摩尔定律正在落幕,不是努力不够,而是物理规律使然。但落幕不等于终结。

华为用韬定律证明:路不止一条,答案不止一种。

它不仅是芯片行业的续命方案,更是中国半导体的破局宣言 ——我们不再跟着别人的规则跑,我们自己定义未来。2026 年秋,麒麟 2026,答案揭晓。