玩转AI-DeepSeek-V4.1-Flash来了:更快、更省,还超过Pro?
大模型竞争,开始从“堆参数”转向“省内存、提效率”
DeepSeek最近发布了V4.1-Flash。名字里虽然有“Flash”,但它并不是简单的轻量版:按照官方测试,新模型在多项任务上已经追平甚至超过V4-Pro,同时速度更快、运行成本更低。
过去的大模型升级,常常围绕一个字:大。参数更多、训练数据更多、算力投入更高。但V4.1-Flash带来的新信号是,模型不一定要在每一步都“全力运转”。如果能重新安排计算方式,同样的任务也可以做得更省。
它不是单纯“变小”,而是换了一种工作方式
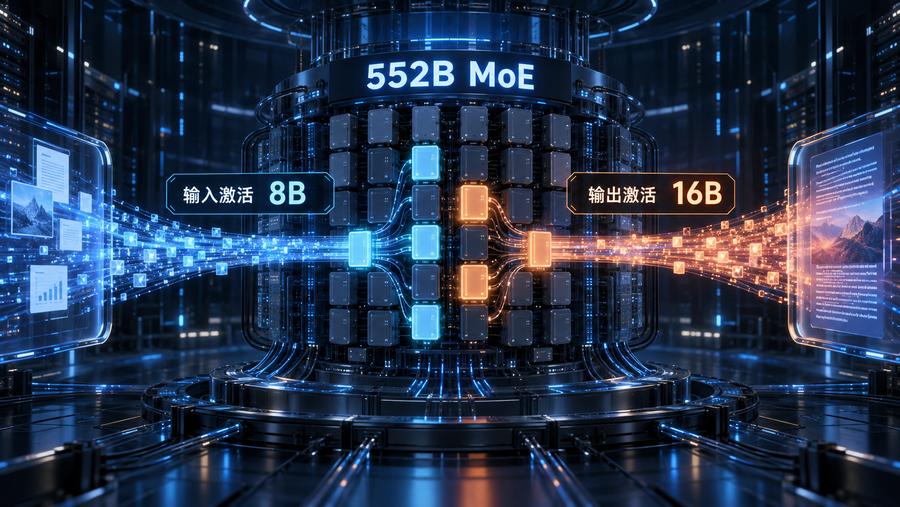
V4.1-Flash是一款5520亿参数的混合专家模型,支持文字和图片输入,最长可处理100万Token的上下文。它可以阅读长文档、分析图表,也能参与需要连续操作的智能体任务。
真正特别的是它采用了新的非对称结构:读取输入时只激活约80亿参数,生成回答时激活约160亿参数。简单理解,就是先用较少资源快速读懂材料,再把更多算力集中到回答阶段。
这很像处理一份很长的报告:浏览和整理资料时不必动用整个专家团队,到了分析和形成结论时,再让更多专家参与。模型的总参数仍然很大,但每一步真正参与工作的参数少得多,因此可以兼顾能力与效率。
能力提升,重点落在“能办事”
从DeepSeek公布的测试看,V4.1-Flash的提升并不只体现在回答问题。它在编程、终端操作、网络安全和办公自动化等Agent任务中表现突出。
例如,在测试软件工程能力的DeepSWE v1.1中,V4.1-Flash取得74.2%的通过率;在Automation-Bench中取得54.8%。这类测试关注的不是模型会不会背知识,而是它能否理解目标、调用工具、处理错误,并把一串步骤真正执行完。
DeepSeek还表示,新模型在知识、推理和代码能力上接近或超过V4-Pro。不过,这些成绩主要来自官方提供的测试环境,不同模型使用的工具、推理预算和运行方式可能并不完全相同,因此更适合看作能力方向,而不是简单的“总冠军排名”。
省下来的,主要是AI的“工作记忆”
长文档和复杂智能体任务会不断积累上下文。模型为了记住前面的内容,需要保存一套名为KV Cache的缓存,就像在桌面上摊开越来越多的工作笔记。
普通聊天只有几轮,笔记不算多;但智能体可能持续工作几十分钟甚至更久,还要阅读文件、观察界面、调用软件并检查结果。任务越长,需要保留的“工作记忆”就越多。缓存逐渐成为速度、并发量和成本的重要瓶颈。
DeepSeek称,V4.1-Flash所需的显存缓存约为上一代的四分之一,需要长期保存到SSD或主机内存的缓存约为八分之一。与DeepSeek第一代模型相比,每个Token所需的全局KV Cache已经缩小约437倍。
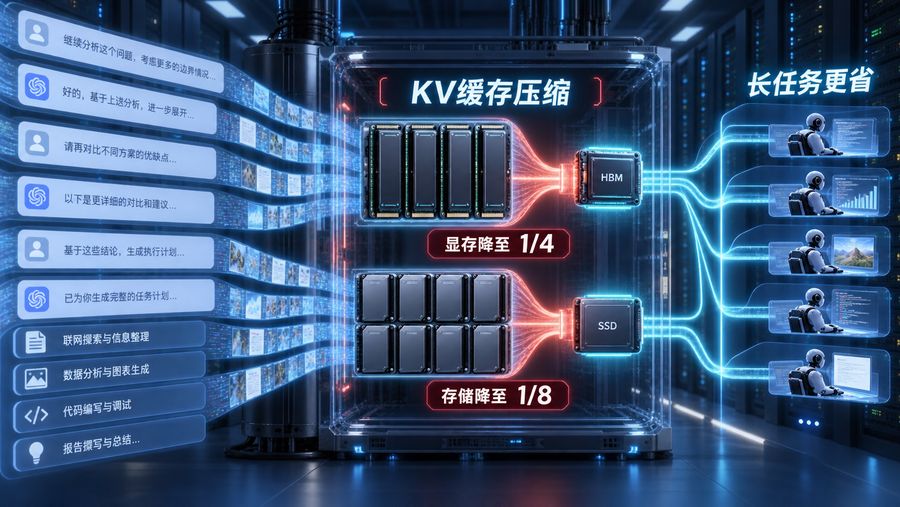
这意味着同样的硬件可以同时承载更多任务,长对话和长流程不必为了“记住前文”付出过高代价。对于真正大规模部署AI的企业来说,这种节省可能比跑分提高几个百分点更有价值。
对使用者来说,最直接的是更快、更便宜
新模型已经上线DeepSeek API,并取代旧版V4-Flash。DeepSeek还宣布,在V4.1-Pro推出前,原V4-Pro请求将暂时转到V4.1-Flash,并按Flash价格计费。
根据官方价格表,闲时缓存命中的输入价格为每百万Token 0.02元,未命中为1元,输出为4元;高峰时段价格翻倍。普通用户未必会直接计算Token,但更低的调用成本会影响AI产品能否提供更长的上下文、更多次工具调用,以及更复杂的自动化功能。
对于开发者和企业,V4.1-Flash的吸引力不只是“单次回答便宜”。当一个智能体每天执行成千上万次任务,缓存、响应速度和并发能力都会被放大。模型每节省一点资源,最后都可能变成真实的服务器成本和产品体验。
这背后的信号比一次降价更重要:大模型的竞争重点,正在从“谁的参数更多”,转向谁能用更少的活跃参数和缓存,完成更复杂、更长时间的任务。
模型不一定要“每一步都全力运转”。把算力用在最需要的地方,可能比一味做大模型更重要。
需要注意:目前“超过V4-Pro”等性能结论主要来自DeepSeek官方测试。技术报告也承认,新模型在部分需要专业科学知识的复杂Agent任务上,与超大型闭源模型仍有差距。真实效果还会因任务、提示词、推理预算和调用方式不同而变化。
V4.1-Flash真正值得关注的,不只是一次跑分领先,而是它展示了一条更现实的路线:让模型保持足够强的能力,同时压低长任务的计算和存储成本。未来真正进入办公、科研和生产流程的AI,拼的可能不只是“有多聪明”,还包括“能否稳定、快速、经济地一直干下去”。