玩转-GPT-6一口气上新两款:Sol更强,Luna更快
大模型不再只争“最强”,而是开始为不同任务明确分工
9月22日,OpenAI推出GPT-6 Sol和GPT-6 Luna,与9月3日发布的旗舰模型Astra形成三层分工:Astra继续负责能力上限,Sol和Luna则补齐更实用的两档,一个面向复杂工作,一个面向快速、重复和大批量任务。
如果说Astra代表“把能力上限推到最高”,那么Sol和Luna更像是把这套能力带进日常工作。OpenAI给出的方向很明确:大多数人不需要每次都调用最昂贵、最强大的模型,而是需要一个能在质量、速度和成本之间做出合适选择的AI系统。
GPT-6开始像一个分工明确的团队
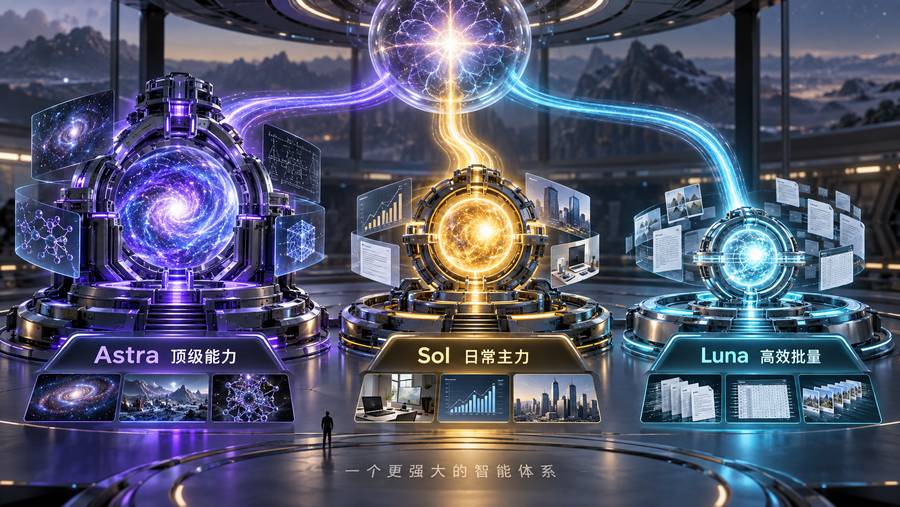
GPT-6家族现在形成了三层结构。Astra负责最困难、最开放的问题,例如复杂研究、跨软件操作和高难度工程任务;Sol面向编程、智能体和需要判断力的日常工作;Luna则针对边界清晰、数量庞大、需要快速完成的任务。
这种设计很像一个团队:最复杂的决策交给资深专家,重要但高频的工作交给主力成员,规则明确的批量任务则交给执行速度更快的成员。目标不是让所有任务都使用同一颗“大脑”,而是把合适的能力放到合适的位置。
Sol是日常主力,重点在复杂工作
OpenAI将Sol定位为复杂编程和智能体工作流的主力模型。它不仅能回答问题,还能调用搜索、文件、代码解释器、终端、电脑操作和MCP等工具,适合处理需要连续执行多个步骤的任务。
Sol支持文字和图片输入,拥有105万Token上下文窗口,单次最多可输出12.8万Token。从规格上看,它可以一次容纳大型代码库、长篇报告或大量项目资料,为后续修改、检查和交付提供更完整的上下文。
更值得注意的是,它支持从“无需深度思考”到更高强度推理的多档设置。面对简单修改时可以快速执行,遇到复杂规划、调试或研究任务时再增加推理投入,不必让每个问题都以最高成本运行。
Luna不是“缩水版”,而是批量工作的效率工具
Luna同样拥有105万Token上下文和完整的工具能力,但定位更偏向聚焦、重复、高频。例如资料分类、信息提取、批量检查、固定格式写作、客服分流和自动化流程,都不一定需要旗舰模型从头深度推理。
在这些场景里,真正重要的是响应快、成本低、能够稳定重复。单次任务节省一点看起来不多,但当企业每天要执行几万甚至几十万次调用时,差距会迅速放大。
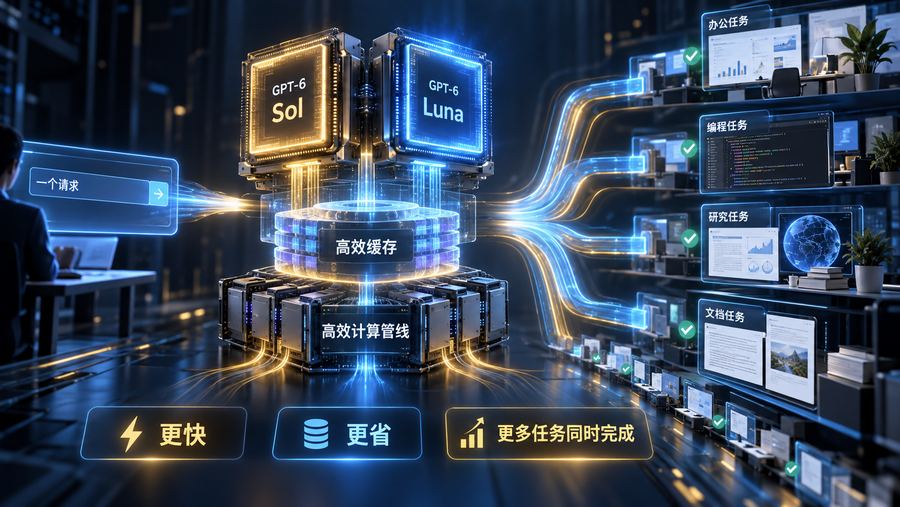
新模型的重点,不只是单价下降
按照OpenAI公布的信息,Sol和Luna改进了缓存与推理效率,相比GPT-5.6同期促销定价降低约一半。API标准计费中,Sol每百万Token输入为2美元、输出为10美元;Luna输入为0.1美元、输出为0.5美元。
但这次更新真正重要的,不是简单地“便宜了”。当模型能够根据任务难度进行分工,AI产品就不必在质量和成本之间二选一:复杂环节交给Sol,明确的小任务交给Luna,最困难的工作再升级到Astra。
这会直接影响AI产品的设计。未来一个自动化系统可能同时使用多种模型:Luna先整理材料、筛选任务,Sol负责分析和执行,只有极少数高难度问题才交给Astra。用户看到的是一个完整助手,背后却是一支按需协作的模型团队。
普通用户什么时候能用到?
Sol和Luna已经进入API,并在ChatGPT Work和Codex中向符合条件的Plus、Pro、Business、Enterprise和Edu用户推出。免费版和Go用户可以在ChatGPT桌面应用中交互式体验Luna,但这不等同于获得免费API额度,程序化调用仍按Token计费。
需要区分的是,它们目前主要服务于Work和Codex,并不是普通Chat聊天界面中同名模型的简单替换。不同账户能够看到的模型、用量和工具也可能有所不同。
大模型竞争正在从“谁有一个最强模型”,转向“谁能让不同模型像团队一样分工”。
模型价格、开放范围和使用额度可能随产品与账户类型调整。实际选择时,不应只看单次Token价格,还要结合任务成功率、运行时间、工具调用次数和人工复核成本。
GPT-6 Sol和Luna释放的信号很清楚:AI走向大规模使用后,最强并不是唯一答案。能够用合适的能力、合适的速度和合适的成本,把任务稳定做完,才是下一阶段真正的竞争力。