探新AI-AI视频开始“边播边听指挥”了
从生成一段影片,到持续生成一个可互动的画面,AI视频正在跨过一道关键门槛
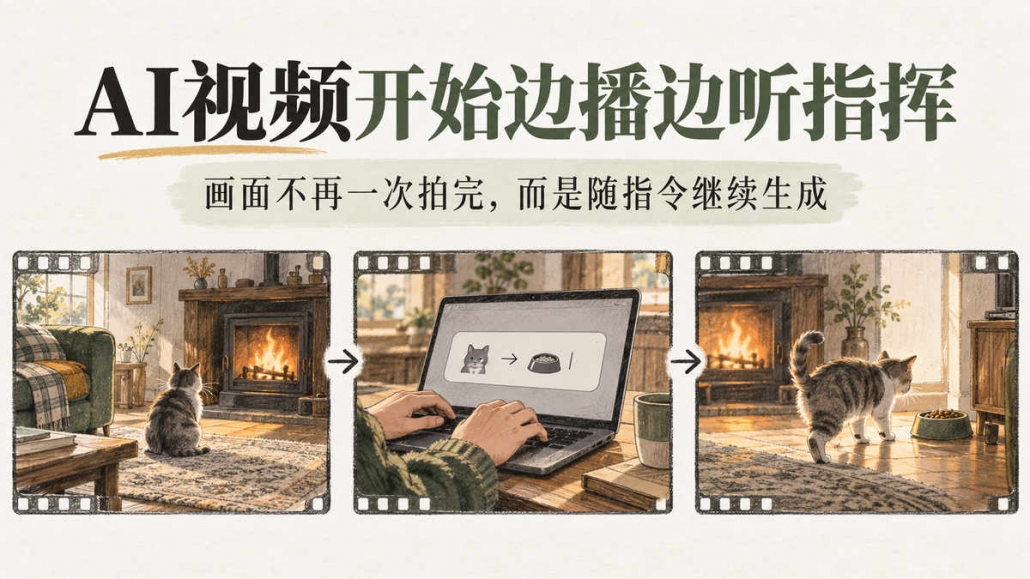
一只猫在壁炉边打盹。视频正播着,输入一句:“旁边放一碗猫粮。”几秒后,碗出现在画面里,猫起身、走过去,还叫了一声。你没有重新拍摄,也没有等系统先渲染好下一段。这不是观众在点“下一集”,而是在现场改剧情。
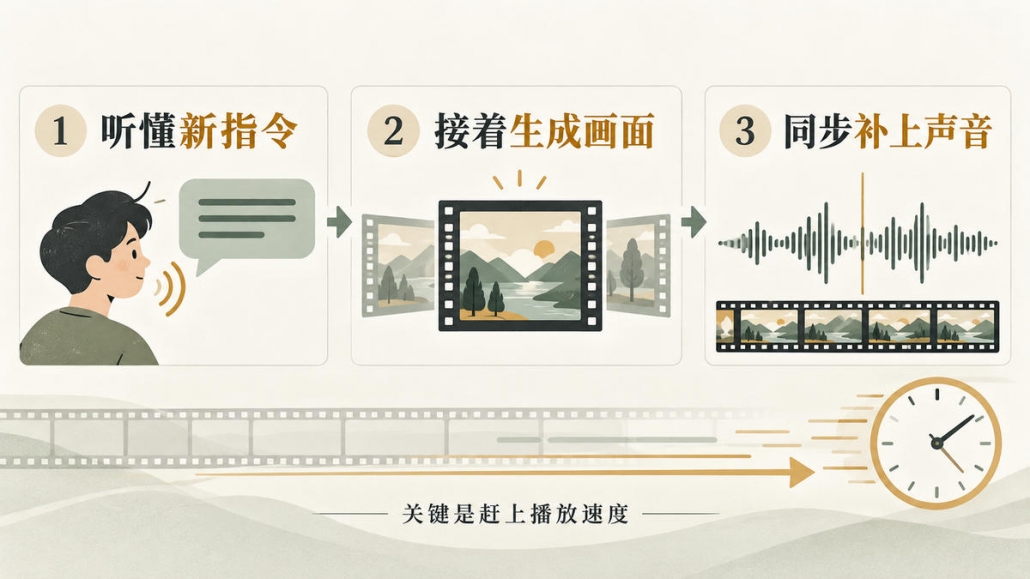
这类体验背后的技术叫“实时世界模型”。它不是把一段现成视频按按钮切换,而是根据刚刚发生的画面和你新给的指令,继续生成接下来的画面与声音。听起来像魔法,真正难的却是一个很朴素的问题:它必须比播放进度跑得快。
01 这次进展,究竟新在哪儿?
10月15日,Visko与Google Cloud联合披露了其Orbis实时视频系统的部署进展:视频生成、画质提升和同步音频被串进同一条实时流水线,在特定测试配置下,生成速度达到播放速度的1.07倍。换句话说,观众看完上一小段前,机器有机会把下一小段准备好。
Orbis的公开演示已在9月1日上线。官方展示中,用户可以在播放过程中继续输入指令,让场景顺势变化。这里有两个值得分清的词:有“公开演示”,不等于所有人都能无限制使用;流水线“达到实时门槛”,也不等于任何场景、任何时长都能稳定运行。
但这已经跨出实验室论文里的一步:团队不只展示模型会生成什么,还公开说明了实际部署的工程过程和速度指标。对普通人来说,最直观的变化是,AI视频从“交作业式地给你一个片段”,开始尝试“边播放边接受导演的临时意见”。
02 普通AI视频,为什么做不到临时改剧情?
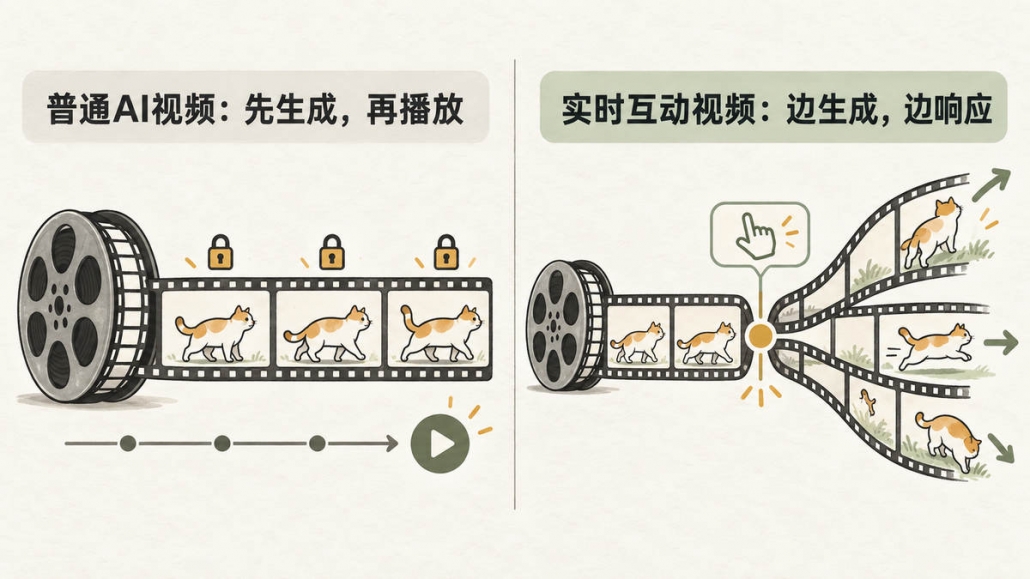
我们熟悉的AI视频,通常像点外卖:写好需求,等一会儿,拿到一段完整成品。它可以很漂亮,但成品里的猫已经走向窗边,你再喊“去吃饭”,画面不会自己转身。想改,只能再生成一段,人物长相、空间位置和前后动作还有可能对不上。
实时互动视频则更像即兴舞台。舞台一直亮着,演员不能暂停十分钟等导演改剧本。系统要记住刚才的环境和动作,接收新指令,再把下一批画面接上去。图里的两条胶片,差别就在这里:一条拍完才放,一条边放边“拍”。
这个“接上去”并不容易。猫上一秒趴在壁炉左边,下一秒不能无缘无故跑到右边;刚出现的食盆也不能一转镜头就消失。模型需要保留近期画面的信息,但又无法像人那样真正理解一间屋子里每个物体的全部物理状态。
03 一边播放一边生成,机器到底忙些什么?
Google Cloud披露的这条流水线,在一个Cloud TPU计算切片上依次完成视频生成、解码、超分辨率处理和音频生成。其目标画面为每秒18帧、1664×936像素。这里的1.07倍不是“快到飞起”,而是勉强领先播放时钟约7%。这点余量,恰恰说明实时生成有多吃紧。
更麻烦的是,它不能轻松提前把未来几十秒都算好:下一秒用户也许就要猫去开门,预先准备的剧情立刻作废。每个新片段还依赖前一个片段,不能像分发独立任务那样随意并行。这也是为什么“做出一段精彩视频”和“让视频连续听指挥”不是同一道题。
04 这跟电子游戏有什么不同?
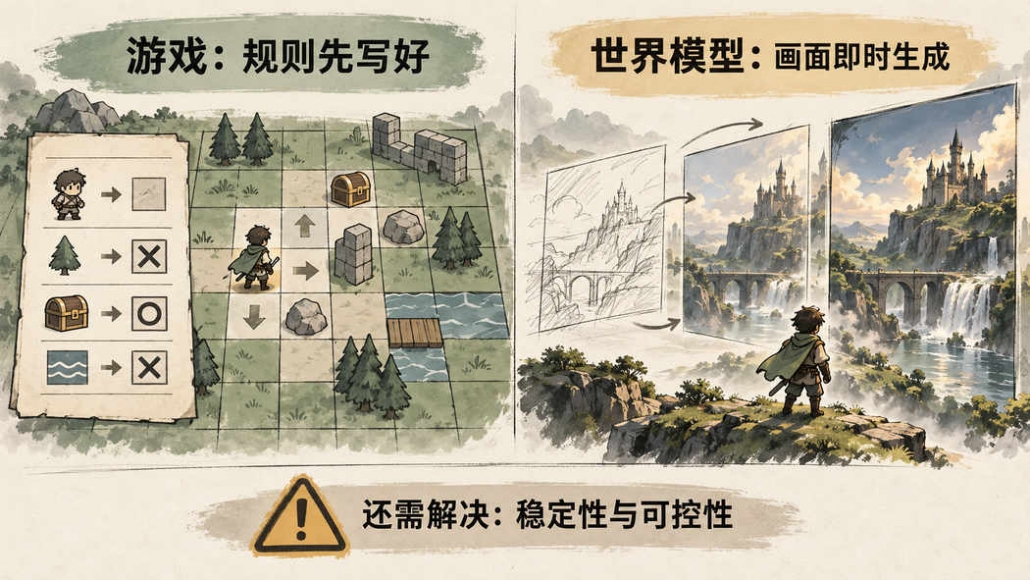
你可能会问:游戏不早就能实时操控角色了吗?没错。但大多数游戏的场景、角色、物理规则和可互动范围,先由开发者制作并写进程序。玩家按下按钮,系统在既定规则里计算结果。画面再开放,也有一张事先搭好的舞台。
世界模型想做的,是在接到文字、声音等输入后,现场生成接下来的视频内容。它可能让你说“下雨了”,画面便朝雨天发展,而不必为每一种可能单独制作素材。开放性是吸引人的地方,却也是难点:自由生成的画面未必总守规矩。
所以,别把“世界模型”四个字误听成“AI已掌握真实世界”。从目前公开材料能确认的是:它展示了连续生成、实时改动场景和部署速度;还不能据此断言它有可靠的物理常识、长期稳定的角色记忆,或能承担严肃训练和决策。
05 真正的新变化是什么?
过去我们讨论AI视频,常问“这段有多像真的”。现在,另一个问题开始冒出来:“我说一句,它能不能当场接住?”技术竞争从单段画质,延伸到了延迟、连续性、声音同步和可控性。片子不再只是作品,也可能变成一场互动。
这给互动娱乐、虚拟角色、产品展示等方向提供了新工具,但距离随手打开就能长时间稳定使用,还有成本、画面一致性、动作合理性和安全边界要过。尤其是用来模拟现实场景时,画面“看着合理”与行为“真的可靠”完全不是一回事。
这次进展最值得记住的,并非猫吃没吃到那碗粮,而是视频生成开始和人的指令同速奔跑。我们第一次能比较具体地看到:一部AI生成的影片,正在从“放给你看”,走向“与你一起往下演”。只是导演喊完“再来一条”,机器能不能场场接得住,还要继续看。