探新AI-5000 亿参数的大模型,每次干活只用 23 亿
——它是不是在摸鱼?
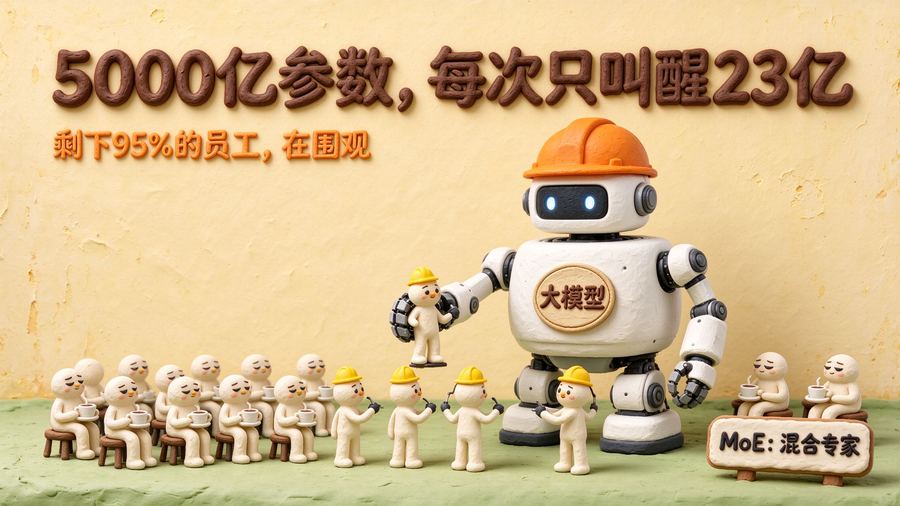
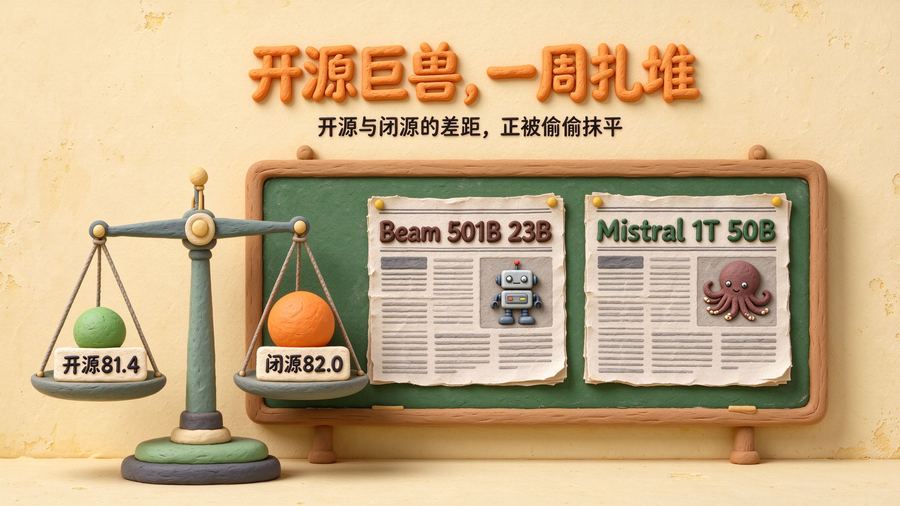
先看两个数字:501B,23B。前者是一个大模型的“总员工数”,后者是它每次回答问题时真正“上班”的人数——只有总人数的不到 5%。剩下 95% 的员工,在围观。这不是什么段子,而是 2026 年 10 月刚发生的真事。10 月 7 日,Reflection AI 发布了开源权重模型 Beam:总参数 5010 亿,但每个 token(每处理一个文字单元)只激活 230 亿参数,还声称在编程、推理和智能体任务上把西方开源模型的前沿往前推了一大截。更关键的是,这不是孤例。开源和闭源的差距,正在被这种“偷偷省力”的架构一点点抹平。
先看新闻:开源“巨兽”扎堆出现
过去一周,开源模型密集上新:
· Reflection AI 的 Beam(10 月 7 日):501B 总参数、23B 激活,稀疏 MoE,主打编码、推理和智能体任务,完整权重本月公开。
· Mistral Large 4(10 月 6 日):号称 1 万亿参数,但每次只激活约 50B;原生多模态,100 万 token 上下文;API 已经能直接调用,权重也开放预览。
与此同时,benchmark 上的差距在肉眼可见地缩小:MMLU 上 Llama 4 Maverick 拿 81.4%,GPT-4o 是 82.0%;数学推理上 DeepSeek R1 拿 97.3%,反而超过了 o1 的 96.4%。有统计说,开源闭源在大多数任务上的差距,已经从两位数缩到 1-3 个点。
而这一切背后的技术引擎,就是标题里那个“摸鱼”架构——MoE。
MoE 是什么?一家“科室会诊”的医院
MoE,全称 Mixture of Experts,混合专家。传统大模型(叫“稠密模型”)像个全科医生。好处是每个病人都被同一个大脑认真对待;坏处是——你为了看个感冒,也让这位医生动用了他全部几十年的医学积累。
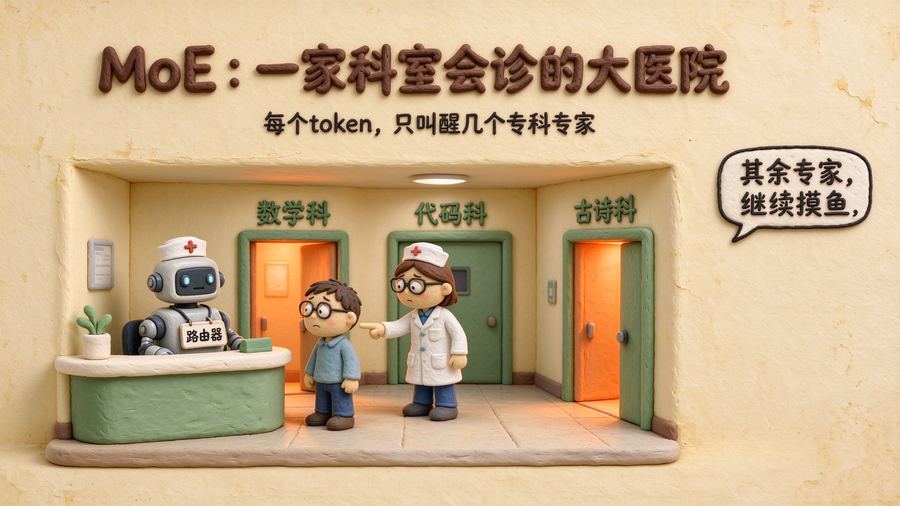
MoE 的思路是把它改成一家大医院:不再是一个全科医生,而是分成几十上百个“专科专家”(比如数学科、代码科、古诗科),再配一个前台分诊员(叫“路由器”)。来了一个 token,分诊员看一眼:“这题像数学,叫数学组和代码组上,其他人歇着。”于是这一次推理,只有少数几个专家真正计算,其余专家保持沉默。
这就是为什么“501B 只激活 23B”不矛盾:总参数是医院的规模,激活参数是每次来病人时真正上班的人数。医院越大,能治的病越多(知识容量大);但每次接诊只叫几个人,成本(算力)就省下来了。
为什么 2026 年才“追上”?
MoE 不是新概念,2017 年就有论文了。为什么这两年才真正爆发出效果?三个原因:
第一,路由练好了。2026 年的模型用上了“带噪声的 Top-k 路由”——不是只派给得分最高的专家,而是故意掺点随机性、多叫几个候选,防止某个专家被累死、其他专家永远闲到生锈(这叫负载均衡)。
第二,共享专家兜底。纯分工有个毛病:有些知识(比如通用常识)几乎所有 token 都用得上,每次都现找太慢。于是模型里常设 1-2 个“全科专家”,每个 token 都过一遍,再叠加专科专家。Kimi K3 的“2 个共享专家”就是这个设计。
第三,训练和推理的配套成熟了。以前 MoE 难训、难部署,容易某个专家过载。现在从训练算法到推理框架(vLLM 等)都有成熟方案,开源社区踩过的坑足够多,新模型可以直接站在前人肩膀上。
已经用到什么程度了?
这不是纸上谈兵。真实世界的证据:
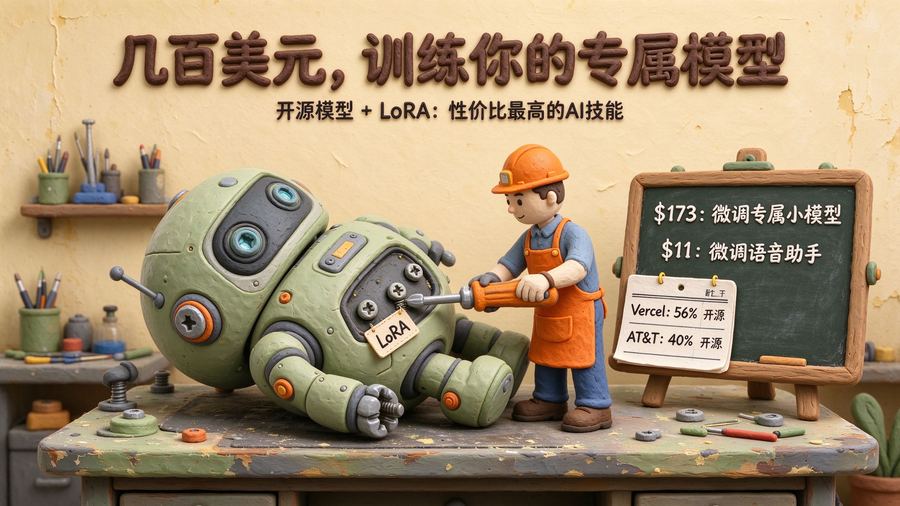
· 企业大规模用开源:Vercel 有 56% 的 token 走开源模型,AT&T 40% 的 AI 负载基于开源模型——不是为了省钱而牺牲效果,而是“效果差不多,成本差很多”。
· 微调成本被打穿:配合 LoRA/QLoRA 这类“只训练一小块”的技术,微调一个开源小模型只需要几百美元量级,甚至有个体开发者花了 173 美元训出一个 40 亿参数模型,在特定任务上干翻了比它大 20 倍的通用模型。
· 普通电脑就能玩:Qwen、DeepSeek 的 7B 级开源模型,配合 4bit 量化,16G 内存的 PC 就能本地跑起来做 LoRA 微调。
限制和坑:摸鱼也是有代价的
别急着把“开源 + MoE”吹上天,它有几个实打实的毛病:
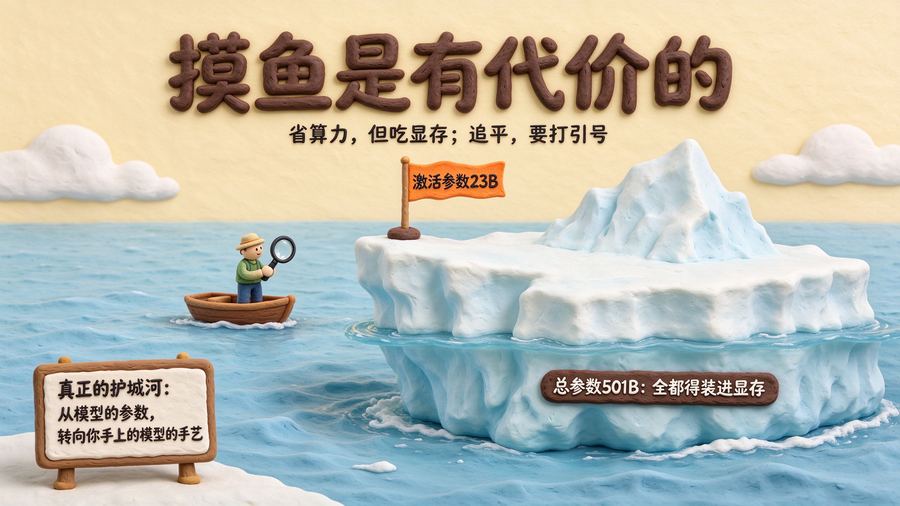
显存是大头。虽然每次只激活 23B,但模型文件还是按 501B 存的——所有专家的权重都得加载进显存,只是推理时不让它们算。所以 MoE 模型“省算力”但“吃显存”,跑起来照样需要好卡。
延迟不一定低。稠密模型是“一步到位”,MoE 要先过路由器、再找专家,流程多了,单个请求的延迟有时反而更高。它省的是大规模吞吐时的总成本,不是单次速度。
训练更难。分诊员要是训练时没学好,某些专家可能永远接不到活(专家崩塌),或某个专家忙到过热。业界还得专门设计负载均衡的损失函数来防。
“追平”要打引号。开源闭源在 benchmark 上差距缩小,但真实世界的长尾能力、安全对齐、多模态细节,闭源旗舰依然领先——尤其你要真去跑 1T 参数的 MoE,本地基本没戏,还是得租云。
那它到底有什么用?
第一,对想动手的同学:“开源模型 + LoRA 微调”是当下性价比最高的 AI 技能之一。几百美元、一台普通电脑,就能训练一个“只为你课题服务的专属模型”——这在三年前是不可想象的。
第二,对整个行业:开源模型逼近闭源,意味着 AI 能力的“民主化”在加速——数据敏感的单位可以自己部署、自己微调、自己审计,不用把数据交给闭源厂商。但也要清醒:跑得起的门槛在降,养得起的门槛还在。真正的护城河,可能正在从“模型的参数”转移到“你手上的数据和你调模型的手艺”。