探新AI-JPEG AI让图片压缩开始学会挑重点
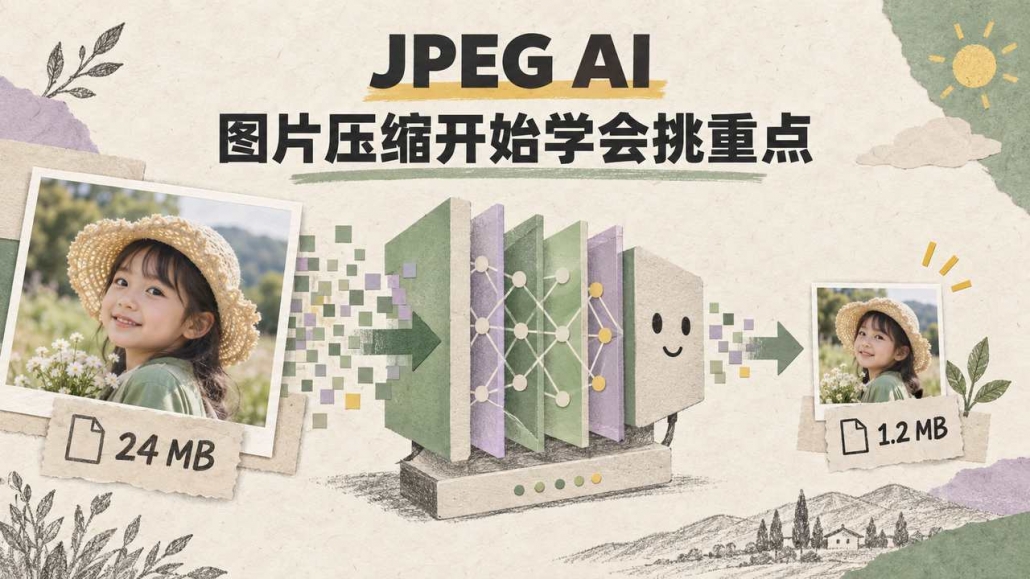
把一张手机照片原封不动地保存,每个像素都要认真登记颜色,手机相册很快就会变成一间塞爆的仓库。JPEG之所以统治图片世界三十多年,靠的正是一项朴素本领:知道哪些信息可以少记一点。
现在,这位老管家迎来了一名会学习的接班人。2025年,ISO正式发布JPEG AI核心编码标准;到2026年,配置规范和文件格式继续落地。它不是给图片加一个“AI滤镜”,而是让神经网络直接参与决定一张照片该怎样被压缩、怎样被保存。
JPEG AI不是让AI替你修图,而是让压缩算法从大量图像中学习怎样更有效地保留信息。
一张照片为什么能被压小
我们熟悉的JPEG,核心思路不是把照片整体缩小,而是找出其中的重复和不敏感信息。它把画面切成小块,把颜色变化转换到频率空间,再少保存一些人眼不容易察觉的细节。最后还要做熵编码,把常见信息写得短一些,把少见信息写得长一些。
这套办法非常成功,也用了三十多年。但它依赖人提前设计好的固定规则。压缩太狠时,天空会出现色带,文字边缘会发毛,脸旁边还可能冒出方块和波纹。
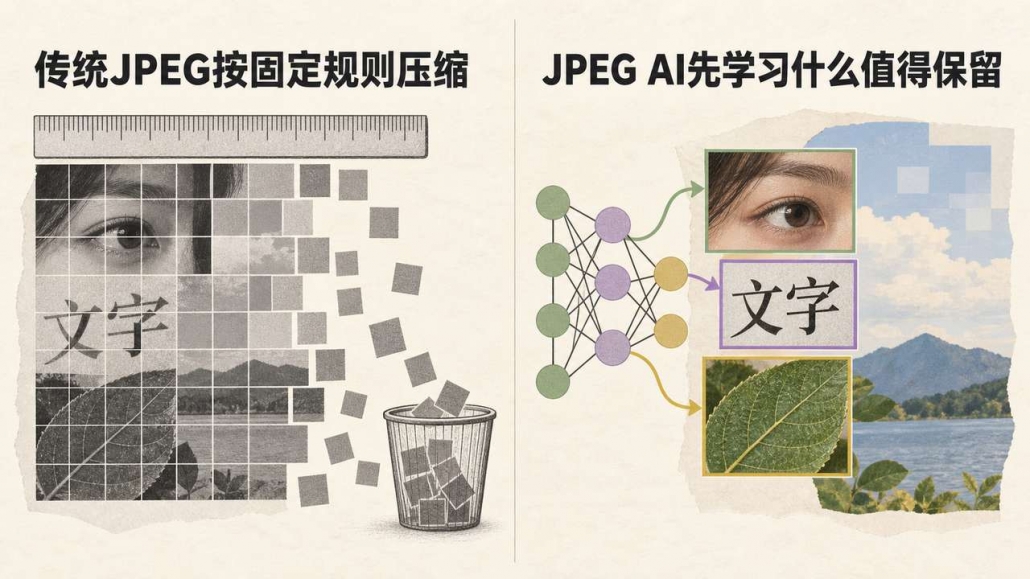
JPEG AI的新主意 让压缩器先学会看图
JPEG AI把最关键的一步交给神经网络:给系统看大量不同内容,让它自己学习哪些视觉特征更值得占用存储空间。人脸的眼睛、路牌上的字、树叶的边缘需要多留一点;大面积平滑天空则可以更大胆地概括。
它的基本结构很像一只会整理行李的箱子。编码器先把原始照片转换成一组更紧凑的“潜在表示”。这不是普通缩略图,而是一批浓缩后的特征数字。随后,这些数字被量化并进行熵编码,变成真正可以存储和传输的比特流。接收端再由解码器把它们还原成图像。
训练时,系统同时面对两张账单:文件不能太大,重建图像也不能太差。压得过轻,存储成本高;压得过狠,细节损失明显。神经网络就在无数图片中寻找两者之间更好的平衡。这类目标通常被称为“率失真优化”,翻译成人话就是:每一个字节,尽量花在最值得的地方。
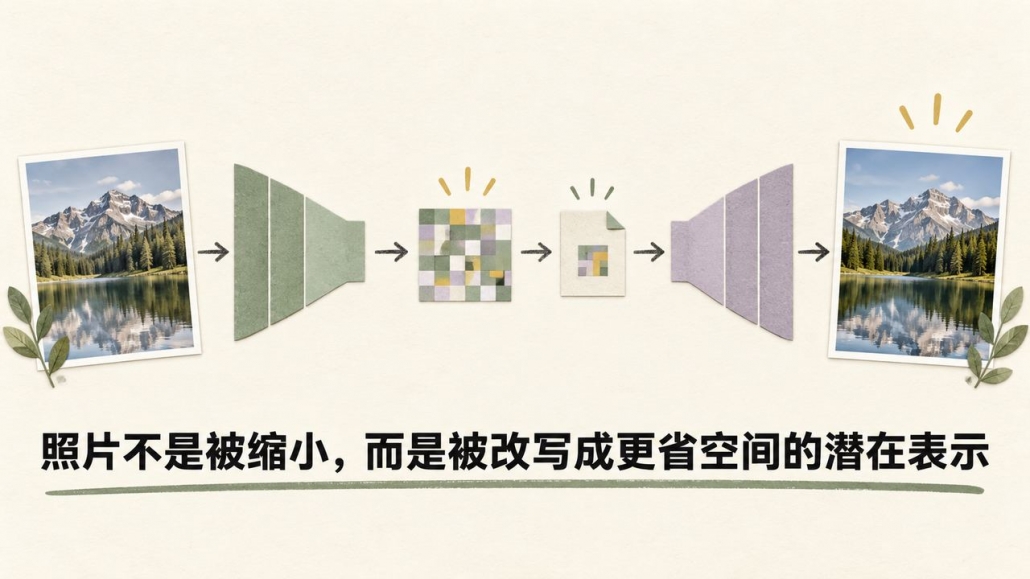
它不是让AI凭空重画照片
听到“神经网络重建”,很多人会担心:AI会不会把没看清的招牌擅自补成另一句话,把远处的人脸换成一个陌生人?这个担心并非毫无道理,因为生成式压缩确实可能在极低码率下补出看似合理、却不一定真实的纹理。
不过,首版JPEG AI核心标准首先面向可控的图像重建,重点仍是定义比特流怎样被解析、图像怎样被恢复,而不是鼓励解码器自由发挥。标准化的意义就在于:不同厂商的设备不能各自“凭感觉”解码,同一份文件必须得到可预期的结果。
同一份数据既给人看也给机器用
JPEG AI真正有野心的地方,不只是把照片压得更小。今天的大量图片并不是先给人看,而是先给机器看:道路摄像头要识别行人,工厂相机要寻找划痕,卫星图像要分析土地变化。传统流程通常先解压成完整图片,再交给识别模型,像是为了让机器读一本书,先把压缩包全部打印出来。
JPEG AI希望压缩后的潜在表示也能服务机器视觉。一份紧凑的数据流,既可以被解码成人眼可见的照片,也可能直接支持分类、检测或分割任务。这样能减少重复解码、数据搬运和存储成本,尤其适合云相册、视觉监控、移动设备和海量科研图像。
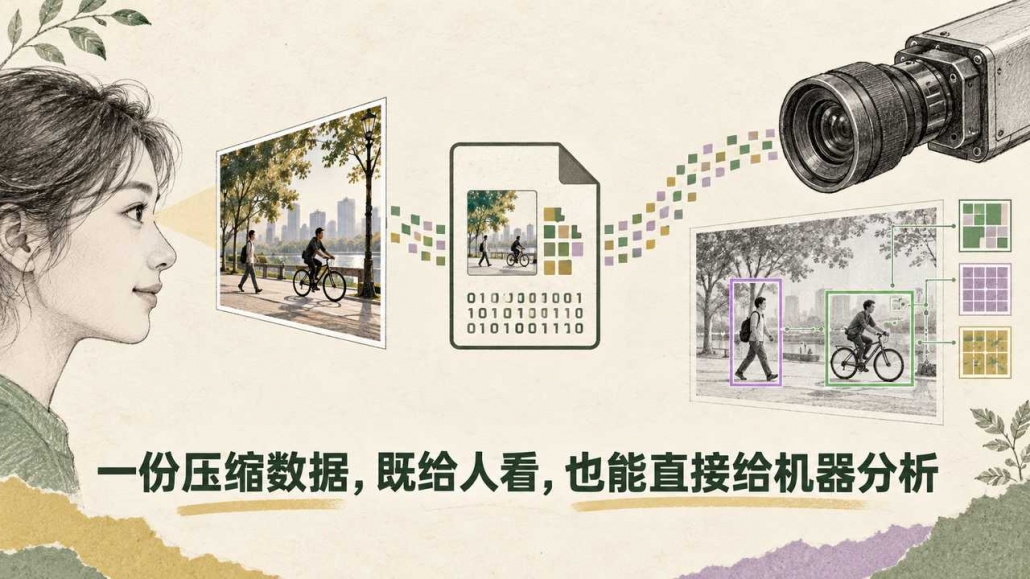
老JPEG会马上退休吗
不会。JPEG最大的超能力从来不是画质,而是“到处都能打开”。网页、打印机、相机、聊天软件和几十年前的电脑几乎都认识它。一个新格式要取代这种兼容性,需要浏览器、操作系统、芯片、编辑软件和内容平台同时跟上,这通常以年为单位。
更可能出现的情况是长期共存:老JPEG继续承担通用分享,JPEG AI先进入云端存储、专业图像库、视觉分析和对容量敏感的设备。等到硬件解码和软件支持逐渐普及,普通用户才会在不知不觉中遇到它。就像我们很少关心手机照片内部用了什么算法,只在意它占得更少、看起来仍然清楚。
JPEG不会马上退休,但图片压缩已经进入了学习时代。